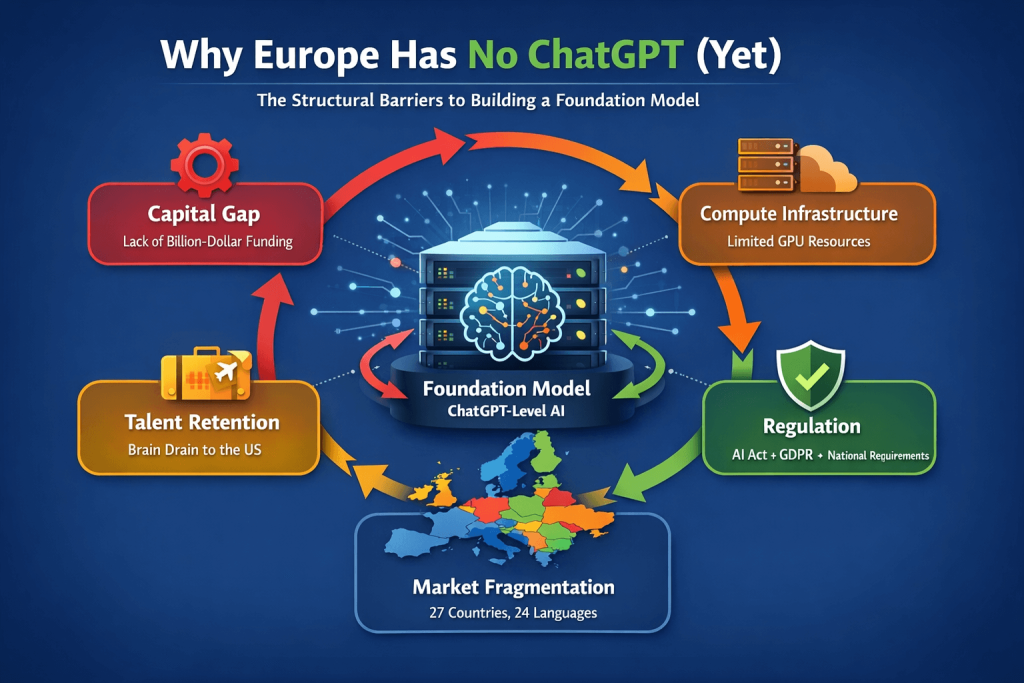
L'Europe n'a pas son propre ChatGPT. Et cela n'est pas dû à un manque de talent ou d'ambition. C'est le résultat de conditions structurelles qui se sont développées au fil des ans et qui ne peuvent être résolues par un seul programme de financement ou un seul discours politique. Pour comprendre pourquoi les alternatives européennes en matière d'IA sont à peine visibles sur le marché des consommateurs, il convient d'examiner cinq facteurs interconnectés.
Ce que signifie réellement le terme “alternative” ici
Avant de chercher les causes, clarifions les termes. Beaucoup d’outils se présentent comme « IA européenne » ou « AI Made in Germany ». La plupart fonctionnent au niveau de la couche applicative : ils utilisent des modèles d’OpenAI, d’Anthropic ou de Google et y ajoutent leur interface, des fonctions de confidentialité ou des fonctionnalités propres à un secteur.
Ce n’est pas un problème en soi. Mais c’est très différent d’un modèle de base : un grand modèle de langage entraîné de zéro avec des données, une infrastructure et des équipes de recherche propres. ChatGPT repose sur GPT-4o, un modèle de ce type. Ici, les « vraies alternatives » désignent ce niveau, plutôt que des interfaces habillées d’un drapeau européen.
Capital : le principal désavantage structurel
Le développement d'un modèle de fondation compétitif nécessite des ressources d'une ampleur que les structures de financement européennes ne peuvent que rarement supporter. Depuis 2023, OpenAI a réalisé plusieurs cycles de financement de plusieurs milliards de dollars. Google, Meta et Microsoft investissent chaque année des dizaines de milliards dans l'infrastructure et la recherche en matière d'IA.
Le capital-risque européen fonctionne à une autre échelle. Les levées de fonds de plusieurs centaines de millions sont déjà exceptionnelles. Mistral AI l’a montré avec ses financements et reste une exception. Les investisseurs européens ont aussi tendance à moins aimer le risque. Aux États-Unis, la volonté d’investir des centaines de millions dans une entreprise qui mettra peut-être des années à devenir rentable est nettement plus forte.
Cela crée un cercle vicieux. Sans financement massif, pas d’entraînement de niveau mondial. Sans modèle de premier plan, pas de produit convaincant. Sans produit convaincant, pas d’utilisateurs, donc pas d’argument pour la prochaine levée de fonds.
Puissance de calcul et infrastructure cloud
Entraîner des modèles de base implique de faire fonctionner des milliers de GPU en parallèle pendant des semaines ou des mois. Cette puissance de calcul est presque entièrement contrôlée par les hyperscalers américains : AWS, Microsoft Azure et Google Cloud. Les fournisseurs européens de services en nuage tels qu'OVHcloud ou IONOS sont forts dans le domaine de l'hébergement traditionnel, mais n'offrent pas d'infrastructure GPU comparable pour l'entraînement à l'IA.
L’UE l’a compris et a lancé des programmes comme EuroHPC pour développer les capacités européennes de calcul intensif. C’est un début. Ces initiatives s’adressent surtout à la recherche et ne couvrent pas la demande commerciale nécessaire pour soutenir plusieurs entreprises de modèles de base en même temps. Aujourd’hui, entraîner un grand modèle de langage en Europe implique probablement de louer des clusters de GPU auprès d’un fournisseur américain.
Le marché des talents : une formation solide, mais une faible rétention
Les universités et instituts de recherche européens produisent des travaux de premier plan en IA. DeepMind a été fondé à Londres. Yann LeCun a étudié à Paris. L’ETH Zurich, l’université technique de Munich et l’EPFL offrent une formation de niveau international.
Le problème est de garder les talents, plutôt que de les former. Les entreprises américaines proposent des salaires et des participations au capital que les employeurs européens égalent rarement. Des équipes plus grandes, des carrières plus rapides et l’accès à des infrastructures sans équivalent en Europe renforcent cette dynamique. La fuite des cerveaux n’est pas nouvelle, mais elle est particulièrement marquée dans l’IA, où la demande de spécialistes dépasse largement l’offre.
Fragmentation du marché : 27 pays, pas de marché unifié
Une startup américaine qui lance un produit en anglais atteint immédiatement un marché de plus de 300 millions de personnes avec un système juridique, une langue et une culture d'entreprise unifiés. Une startup européenne est confrontée à 27 pays avec des langues, des réglementations et des mécanismes de financement différents.
L'UE est un marché unique pour les marchandises. Pour les produits numériques - en particulier les applications d'IA soumises à des exigences réglementaires - elle n'est que partiellement unifiée. Les programmes de financement sont fragmentés au niveau national. Les processus de passation de marchés suivent des logiques différentes. Même au sein de l'UE, les exigences de mise en œuvre de la protection des données varient en fonction des autorités de contrôle nationales. Cela rend la mise à l'échelle plus coûteuse et plus lente qu'aux États-Unis ou en Chine.
| Sujet | États-Unis | Union européenne |
|---|---|---|
| Accès au marché | Un marché unifié, plus de 330 millions de personnes | 27 pays, marché fragmenté |
| Langue | Une langue pour un lancement de produit | 24 langues officielles, localisation requise |
| Le cadre juridique | Un système fédéral, un ensemble de règles | 27 interprétations nationales du droit communautaire |
| Le paysage du financement | Les tours de table de plusieurs milliards de dollars sont fréquents | Les levées de fonds de plus de 500 millions d’euros restent exceptionnelles |
| Financement public | Programmes fédéraux centralisés (DARPA, NSF) | Fragmentation des programmes nationaux et européens |
| Marchés publics | Procédure unique de passation des marchés publics fédéraux | 27 systèmes de marchés publics différents |
| Contraintes réglementaires | Plus léger, plus rapide à mettre sur le marché | Loi sur l'IA + RGPD + exigences nationales |
| Rétention des talents | Salaires élevés, participations au capital et programmes de visas | Fuite des cerveaux vers les États-Unis, abaissement du plafond de rémunération |
| Infrastructure en nuage | Les hyperscalers ont leur siège dans le pays | Dépendance à l'égard des hyperscalers américains pour l'accès au GPU |
| Temps de mise à l'échelle | Lancer une seule fois, étendre immédiatement | Déploiement pays par pays |
Réglementation : Obstacle ou avantage concurrentiel ?
La loi sur l'IA, le RGPD et diverses réglementations nationales créent un cadre de conformité que les startups américaines n'ont pas à parcourir dans la même mesure. Pour une jeune entreprise aux ressources limitées, chaque exigence réglementaire supplémentaire signifie moins de budget pour le développement de produits.
Dans le même temps, le contre-argument a du mérite. La réglementation peut créer un avantage en termes de confiance. Dans certains secteurs - soins de santé, finance, administration publique -, les entreprises qui fonctionnent manifestement dans le respect du RGPD ont un avantage certain par rapport aux fournisseurs américains dont le traitement des données ne répond que partiellement aux normes européennes.
La réponse honnête est que la réglementation est les deux à la fois. Elle ralentit le développement des produits de consommation, mais pose les bases d'applications B2B fiables. Ceux qui s'attendent à ce que l'Europe produise un deuxième ChatGPT seront probablement déçus. Ceux qui recherchent des solutions d'IA souveraines pour les industries réglementées les trouveront de plus en plus ici.
Le paysage européen de l’IA : état des lieux en 2025/2026
Malgré ces désavantages structurels, des entreprises européennes développent leurs propres modèles de base. Elles sont peu nombreuses, mais elles existent.
Mistral AI, en France, est l’acteur européen le plus connu. L’entreprise a publié plusieurs modèles qu’elle a développés, dont des versions open source. Elle se positionne comme une alternative performante à OpenAI, avec un accent sur l’accès par API pour les développeurs et les entreprises. Mistral a obtenu la plus grande levée de fonds européenne dans l’IA et travaille avec de grands fournisseurs cloud. Son produit grand public, Le Chat, existe, mais il n’est pas au centre de sa stratégie.
Aleph Alpha (Allemagne) s'est délibérément spécialisée dans les marchés B2B et du secteur public. Au lieu de concurrencer ChatGPT sur le marché grand public, l'entreprise cible les cas d'utilisation dans les industries réglementées avec un hébergement propriétaire et la souveraineté européenne en matière de données. Son repositionnement stratégique de ces dernières années illustre une tendance plus large : les fournisseurs européens ont plus de chances de réussir grâce à la spécialisation qu'à la concurrence sur le marché de masse.
En outre, il existe des initiatives plus modestes et des projets à code source ouvert, émanant par exemple d'instituts de recherche ou de consortiums financés par l'UE. Ils sont pertinents pour des cas d'utilisation spécifiques, mais n'apparaissent pas comme des produits destinés au grand public.
Un aperçu complet des alternatives européennes en matière d'IA et des outils spécialisés est disponible ici :
L'Europe a-t-elle besoin de son propre ChatGPT ?
L’idée est de créer une copie à l’identique pour le grand public, portée par des discours politiques sur la souveraineté numérique ou l’indépendance stratégique.
L'accent est mis sur le traitement des données, le contrôle contractuel, la gestion des dépendances et les décisions d'architecture fondées sur le risque.
On répond souvent à cette question par un oui réflexe : souveraineté numérique, indépendance stratégique, valeurs européennes. Ces arguments sont valables. Mais ils deviennent trompeurs s'ils conduisent à exiger un clone univoque du ChatGPT.
La question stratégique est plutôt celle-ci : où l’Europe a-t-elle vraiment besoin de ses propres modèles, et où une couche applicative souveraine reposant sur des modèles de base existants suffit-elle ? Pour la plupart des usages en entreprise, l’essentiel est de savoir où les données sont traitées, quels contrats s’appliquent et comment limiter la dépendance à chaque fournisseur. Cela exige surtout une architecture bien conçue, sans forcément nécessiter un modèle de base européen.
La situation est différente pour les applications critiques en matière de sécurité - défense, services de renseignement, infrastructures critiques. Dans ce cas, la dépendance à l'égard des modèles américains représente un véritable risque. Dans ces domaines, la souveraineté numérique au niveau du modèle est vraiment pertinente. Pour le processus commercial moyen, elle ne l'est que partiellement.
Ce que les entreprises européennes peuvent faire maintenant
Attendre un ChatGPT européen n'est pas une stratégie. Quatre approches plus pragmatiques le sont :
Utiliser des modèles américains dans le respect du RGPD. Plusieurs fournisseurs proposent désormais des accords européens d'hébergement et de traitement des données qui répondent aux exigences du RGPD. Les options d'hébergement européen d'OpenAI, le service Azure OpenAI avec des centres de données européens et les offres comparables d'Anthropic et de Google permettent d'utiliser des modèles puissants dans les cadres réglementaires européens.
Évaluer les fournisseurs européens pour les cas d'utilisation spécialisés. Les entreprises opérant dans des secteurs réglementés ou exigeant une souveraineté maximale des données devraient évaluer des fournisseurs tels que Mistral ou Aleph Alpha. Leurs modèles sont suffisamment puissants pour de nombreuses applications B2B et offrent des avantages en matière de conformité et de conception de contrats.
Évite la dépendance à un seul fournisseur. L’IA évolue vite. Une entreprise qui se lie entièrement à un fournisseur aujourd’hui peut rencontrer des difficultés dans deux ans si les prix, les licences ou les performances changent. Des couches d’abstraction et une architecture avec plusieurs fournisseurs sont donc utiles.
Développe ton expertise au lieu d’attendre. Les entreprises qui expérimentent l’IA dès maintenant, y compris avec des modèles américains, acquièrent une expérience difficile à rattraper plus tard. La question centrale est moins « quel modèle ? » que « quel processus en bénéficie ? ».
Tu trouveras ici des conseils de mise en pratique et un aperçu des alternatives européennes concrètes.
Conclusion
L’Europe ne produira probablement pas son propre ChatGPT à court terme. Les raisons sont structurelles : le capital, l’infrastructure, la rétention des talents et la fragmentation du marché interagissent et ne se règlent pas séparément. Mistral et Aleph Alpha montrent qu’il est possible de créer ses propres modèles de base, avec des priorités et un positionnement différents de ceux de ChatGPT.
Pour les entreprises, cela signifie que la meilleure stratégie n'est pas d'attendre, mais d'utiliser souverainement les modèles existants dans les cadres européens. Avec la bonne architecture, il est possible de combiner performance et conformité sans dépendre d'un équivalent européen qui ne verra probablement pas le jour de sitôt.