Warum die Frage nach einem europäischen KI-Schreibtool überhaupt relevant ist
Wer ein KI-Schreibtool im Content-Team einführen möchte, bekommt oft schneller Fragen aus der Rechtsabteilung als aus der Redaktion: Wo genau werden die Texte – und die Daten, auf deren Grundlage sie entstehen – verarbeitet? Viele KI-Schreibdienste, darunter bekannte Tools wie ChatGPT, Jasper, Copy.ai und Writesonic, stammen von Anbietern mit Sitz in den USA oder nutzen dort ansässige Unterauftragsverarbeiter. Wo Daten tatsächlich gespeichert und verarbeitet werden, hängt jedoch vom Produkt, Tarif, der Cloud-Region und den vertraglichen Vereinbarungen ab; einige Enterprise-Angebote ermöglichen zudem eine regionale Steuerung der Datenverarbeitung. Der Standort des Nutzers sagt daher wenig darüber aus, wo seine Daten tatsächlich landen. Dabei geht es nicht nur um Datenresidenz und Dokumentation, sondern auch um konkrete technische und organisatorische Sicherheitsfragen – etwa zu Zugriffskontrollen, Aufbewahrungsfristen, dem Umgang mit Sicherheitsvorfällen und dem Risiko, dass vertrauliche Eingaben offengelegt oder erneut verwendet werden.
In der Praxis zeigt sich die Herausforderung vor allem in den Prüf- und Freigabeprozessen. Die Prüfung eines neuen Softwareanbieters kann in einem mittelständischen Unternehmen wenige Tage bis mehrere Wochen dauern – je nachdem, wie schnell die Rechtsabteilung das Data Processing Agreement (DPA), die Liste der Unterauftragsverarbeiter und den Mechanismus für internationale Datenübermittlungen bewerten kann und wie sensibel die betroffenen Daten sind. Bei KI-Schreibtools kann eine solche Prüfung erneut notwendig werden, wenn der Anbieter den zugrunde liegenden Modellanbieter wechselt. Dadurch kann sich die Verarbeitungskette ändern, obwohl das sichtbare Produkt unverändert bleibt. Für Redaktionsteams mit täglichen oder wöchentlichen Veröffentlichungszyklen entsteht so leicht ein Spannungsfeld zwischen schnellen Content-Prozessen und deutlich langsameren Beschaffungs- und Freigabeprozessen. An diesem Punkt überschneiden sich in Suchanfragen auch Begriffe wie "europäisches KI-Schreibtool" und "EU-AI-Act-konform", obwohl dahinter unterschiedliche Fragestellungen stehen. Die regulatorische Seite wird ausführlicher in diesem Leitfaden behandelt: So lässt sich die Einhaltung des EU AI Act bei europäischer KI-Software bewerten.
Wann ist ein KI-Schreibtool wirklich "europäisch"?
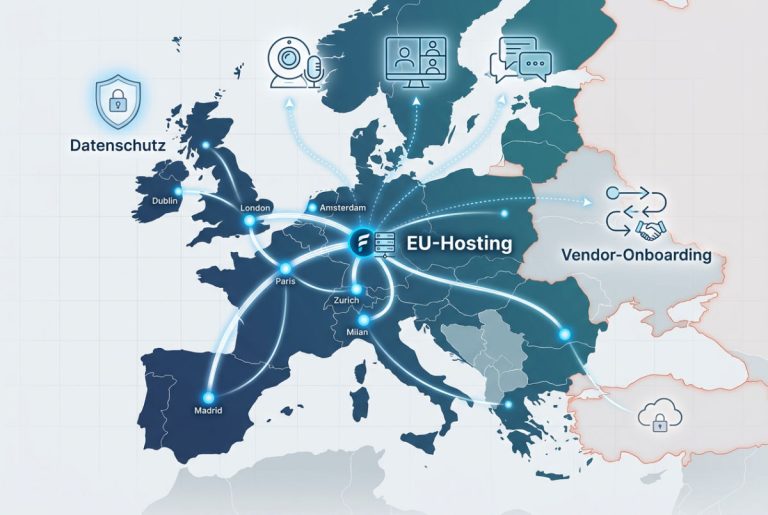
Eine einheitliche rechtliche Definition für ein "europäisches KI-Schreibtool" gibt es nicht. Für eine sinnvolle Bewertung sollten drei Faktoren getrennt voneinander betrachtet werden: der Unternehmenssitz, der Ort der Datenverarbeitung und die Herkunft des zugrunde liegenden Sprachmodells. Aus keinem dieser Punkte lässt sich automatisch auf die beiden anderen schließen, auch wenn Marketingseiten diese Unterschiede nur selten klar benennen. Außerdem ist entscheidend, was mit "europäisch" überhaupt gemeint ist: die EU, der gesamte Europäische Wirtschaftsraum (EWR) oder Europa im weiteren Sinne. Das Vereinigte Königreich, die Schweiz und andere europäische Länder außerhalb der EU bzw. des EWR haben eigene Datenschutz- und Übermittlungsregelungen, die nicht automatisch den EU-Vorgaben entsprechen.
- Unternehmenssitz: Wo der Anbieter rechtlich registriert ist (z. B. in Deutschland, Frankreich oder den Niederlanden). Daraus ergibt sich, welches Gesellschafts- und Steuerrecht gilt. Es sagt jedoch nichts darüber aus, wo die Server stehen oder welches KI-Modell die Texte erzeugt.
- Ort der Datenverarbeitung: Wo Prompts, Entwürfe und Kontodaten tatsächlich gespeichert und verarbeitet werden. Auch ein in der EU entwickeltes Tool kann Daten über eine US-Cloud-Region verarbeiten, sofern der Vertrag nicht ausdrücklich ein Hosting ausschließlich in der EU bzw. im EWR zusichert.
- Herkunft des KI-Modells: Ob das Schreibtool ein selbst trainiertes Sprachmodell nutzt, ein in der EU entwickeltes Modell lizenziert oder im Hintergrund auf ein US-basiertes Foundation Model zugreift, beispielsweise per API. Gerade dieser Punkt bleibt im Marketing vieler Anbieter häufig unerwähnt.
- "In Europa gehostet" vs. "in Europa entwickelt": Ersteres beschreibt ausschließlich den Serverstandort. Letzteres bezieht sich darauf, wo die Software und im Idealfall auch das Modell entwickelt wurden. Ein Tool kann in einem EU-Rechenzentrum gehostet werden und dennoch ein Modell außerhalb der EU nutzen – und umgekehrt.
- Drei typische Konstellationen am Markt: EU-Unternehmen + in der EU entwickeltes Modell; EU-Unternehmen + Nicht-EU-Modell, meist aus den USA, das per API eingebunden wird; EU-Unternehmen + hybride Lösung aus EU-Infrastruktur und einem lizenzierten oder Open-Source-Modell.
Die Pflichten aus dem EU AI Act richten sich in erster Linie nach der Rolle einer Organisation – etwa als Anbieter eines General-Purpose-AI-Modells (GPAI), Anbieter eines KI-Systems oder Betreiber – sowie danach, ob das Modell oder System auf dem EU-Markt angeboten oder eingesetzt wird. Das Land, in dem ein Modell ursprünglich entwickelt wurde, ist für sich genommen nicht ausschlaggebend. Ein Anbieter eines KI-Schreibtools, der ein General-Purpose-AI-Modell eines Drittanbieters integriert, benötigt möglicherweise bestimmte Informationen vom Modellanbieter und kann eigene Pflichten auf Systemebene haben. Er übernimmt jedoch nicht automatisch dessen GPAI-Transparenz- und Dokumentationspflichten, nur weil sein Unternehmen in der EU ansässig ist.
Warum europäische Organisationen Alternativen zu US-Tools prüfen
Das Interesse an Alternativen ist meist Teil des Risikomanagements und keine grundsätzliche Präferenz für eine bestimmte Region. Bei Beschaffungsprüfungen tauchen vor allem drei Faktoren immer wieder auf.
Erstens benötigen grenzüberschreitende Übermittlungen personenbezogener Daten eine gültige Grundlage nach Kapitel V der DSGVO. Liegt für das Zielland ein Angemessenheitsbeschluss vor, können Daten in der Regel ohne Standardvertragsklauseln (SCCs) oder eine separate Bewertung der Auswirkungen der Datenübermittlung (Transfer Impact Assessment) übermittelt werden. Werden stattdessen SCCs oder andere Garantien nach Artikel 46 genutzt, muss die datenexportierende Organisation prüfen, ob diese Schutzmechanismen im jeweiligen Zielland tatsächlich wirksam sind, und gegebenenfalls zusätzliche Maßnahmen ergreifen. Je nach Komplexität der Unterauftragsverarbeiterkette kann dies für den Datenschutzbeauftragten mehrere zusätzliche Arbeitsstunden pro neuem Anbieter bedeuten. Diese Regelungen betreffen ausdrücklich personenbezogene Daten. Für vertrauliche, aber nicht personenbezogene Geschäftsdaten sind vor allem vertragliche Vereinbarungen, Sicherheitsanforderungen und gegebenenfalls branchenspezifische Vorschriften maßgeblich. Zweitens spielt das Konzentrationsrisiko eine Rolle, wenn bereits mehrere geschäftskritische Tools von denselben ein oder zwei großen US-Cloud-Anbietern abhängen. Ein weiteres KI-Schreibtool aus demselben Technologie-Stack erhöht diese Abhängigkeit, anstatt sie zu diversifizieren. Drittens sehen Beschaffungsrichtlinien im öffentlichen Sektor und in regulierten Branchen wie Finanzwesen, Gesundheitswesen oder Rechtsdienstleistungen häufig eine formelle oder informelle Präferenz für die Datenverarbeitung in der EU bzw. im EWR vor. Das ist Teil eines umfassenderen Anbieterrisikomanagements und keine pauschale Ablehnung von Software außerhalb der EU.
| Faktor | Typischer Auslöser | Praktische Auswirkung |
|---|---|---|
| Datenübermittlung und Schutzmaßnahmen | Neuer Anbieter nutzt einen Auftragsverarbeiter außerhalb des EWR | DSB-Prüfung des Übermittlungsmechanismus je Anbieter |
| Anbieterkonzentration | Mehrere zentrale Tools beim selben Cloud-Anbieter | Zusätzlicher Eintrag im Risikoregister, aber kein Ausschlusskriterium |
| Branchenspezifische Beschaffungsrichtlinie | Öffentlicher Sektor, Finanzwesen, Gesundheitswesen, Rechtsdienstleistungen | Präferenz für EU-/EWR-Hosting in den Ausschreibungskriterien |
| Vertragsverlängerung | Jährliche oder zweijährliche SaaS-Verlängerung | Natürlicher Zeitpunkt für eine erneute Anbieterbewertung |
Daraus lässt sich keine allgemeine Regel ableiten, wonach EU-Tools grundsätzlich sicherer und US-Tools grundsätzlich riskanter wären. Entscheidend ist vielmehr eine individuelle Abwägung anhand der Risikotoleranz der jeweiligen Organisation, ihrer Vertragszyklen und der branchenspezifischen Anforderungen.
Bewertungskriterien für europäische KI-Schreibtools
Produktnamen, Tarife und Funktionslisten ändern sich zu häufig, um dauerhaft als verlässliche Vergleichsgrundlage zu dienen. Eine Tabelle auf Basis der heutigen Marketingseiten kann schon im nächsten Quartal veraltet sein. Eine kriterienbasierte Checkliste ist deshalb für die interne Bewertung belastbarer als ein statischer Produktvergleich. Dieser Leitfaden konzentriert sich daher auf den Beschaffungs- und Data-Governance-Prozess und nicht auf ein Ranking einzelner Produkte.
Fünf praktische Prüfungen bilden den Kern einer auf Compliance ausgerichteten Bewertung:
| Kriterium | Was geprüft werden sollte | Wo Nachweise zu finden sind |
|---|---|---|
| Unternehmenssitz | Rechtsträger und Registrierungsland | Impressum, Angaben zum Vertragspartner im DPA |
| Ort der Datenverarbeitung | Rechenzentrumsregion für Speicherung und Verarbeitung | Liste der Unterauftragsverarbeiter, DPA-Anhang |
| Herkunft des KI-Modells | Eigenes, lizenziertes oder per Drittanbieter-API eingebundenes Modell | KI-/Modelldokumentation des Anbieters |
| Transparenz bei Trainingsdaten | Ob Kundeneingaben standardmäßig für das Modelltraining verwendet werden | Nutzungsbedingungen, Opt-out-Regelung |
| Vertragsbedingungen | Aufbewahrungsfristen, Löschverfahren, Haftungsbegrenzungen | DPA, Rahmenvertrag (Master Service Agreement) |
Drei Prüfungen eignen sich als erste Filter, bevor man tiefer einsteigt: die aktuelle Liste der Unterauftragsverarbeiter und die Verarbeitungskette bestätigen, sich schriftlich zusichern lassen, ob Prompts und Entwürfe für das Modelltraining verwendet werden und gegebenenfalls ein Opt-out vereinbaren sowie das tatsächlich eingesetzte Foundation Model identifizieren, statt sich mit Angaben wie "fortschrittliche KI" oder "proprietäre Technologie" zufriedenzugeben. Diese Punkte sind ein sinnvoller Ausgangspunkt, aber für sich allein noch kein Nachweis für Compliance. Eine umfassendere Prüfung sollte außerdem die betroffenen Datentypen und Verarbeitungszwecke, die Rollen von Verantwortlichem und Auftragsverarbeiter, die Rechtsgrundlage bei der Verarbeitung personenbezogener Daten, Aufbewahrungs- und Löschverfahren, Sicherheitsmaßnahmen, Betroffenenrechte sowie die Frage umfassen, ob für den konkreten Anwendungsfall eine Datenschutz-Folgenabschätzung oder eine Transferprüfung erforderlich ist. Wie lange dieser Prozess dauert, hängt stark davon ab, wie schnell und vollständig der Anbieter die erforderlichen Unterlagen bereitstellt und wie komplex die Kette der Unterauftragsverarbeiter ist. Ein gut dokumentierter Fall mit geringem Risiko kann schnell freigegeben werden, während zusätzliche Rückfragen oder rechtliche Verhandlungen den Prozess deutlich verlängern können.
Vergleiche zwischen Anbietern auf Basis öffentlicher Marketingseiten haben einen entscheidenden Nachteil: Preise, Modellversionen und Hosting-Konfigurationen können sich ändern, ohne dass Anbieter dazu öffentliche Änderungsprotokolle führen. Jeder Vergleich, der als Grundlage für eine Kaufentscheidung dient, sollte deshalb direkt anhand des aktuellen DPA des jeweiligen Anbieters überprüft werden, statt sich allein auf Zusammenfassungen Dritter – einschließlich dieser – zu verlassen. Für eine erste Vorauswahl europäischer Schreibassistenten werden häufig DeepL Write, LanguageTool und neuroflash genannt. Für den konkret betrachteten Tarif sollten jedoch weiterhin der Rechtsträger, die Verarbeitungsregion, die Unterauftragsverarbeiter und der Modellanbieter geprüft werden. Neben Compliance sollten die Favoriten außerdem anhand realistischer Schreibaufgaben, Sprachabdeckung, faktischer Zuverlässigkeit, redaktioneller Kontrollmöglichkeiten, Integrationen, Benutzerfreundlichkeit und Gesamtkosten verglichen werden. Erst diese Faktoren zeigen, ob ein Tool im redaktionellen Alltag tatsächlich geeignet ist.
Europäisches Tool oder US-Alternative: Wann ist welche Wahl sinnvoll?
Keine der beiden Optionen ist grundsätzlich die richtige. Entscheidend ist, welche Anforderungen für die jeweilige Organisation am stärksten wiegen und welches konkrete Produkt bzw. welcher Tarif betrachtet wird – nicht allein das Herkunftsland des Anbieters. Ein europäisches Tool kann besonders dann besser passen, wenn interne Richtlinien oder Kundenverträge strenge Vorgaben zur Datenresidenz machen, Ausschreibungen des öffentlichen Sektors eine Verarbeitung in der EU bzw. im EWR verlangen, in regulierten Branchen wie Finanzwesen, Gesundheitswesen oder Rechtsdienstleistungen konkrete gesetzliche, vertragliche oder interne Vorgaben gelten oder strategisch die Abhängigkeit von wenigen großen US-Cloud- und KI-Anbietern reduziert werden soll. Wichtig ist jedoch: Selbst eine verbindliche Vorgabe zur Datenverarbeitung innerhalb der EU kann grundsätzlich auch ein Anbieter außerhalb der EU erfüllen, wenn er eine passende regionale Bereitstellung anbietet. Entscheidend ist, wo die Daten tatsächlich verarbeitet werden – nicht automatisch, wo der Anbieter seinen Hauptsitz hat.
Je nach Modell, Version und Bereitstellungsform kann auch ein nicht europäisches Tool die pragmatischere Wahl sein. Einige große Foundation Models werden sehr häufig aktualisiert, unterstützen besonders große Kontextfenster für lange Dokumente oder liefern starke mehrsprachige Ergebnisse in vielen wichtigen Weltsprachen. Solche Eigenschaften hängen stärker vom konkreten Produkt und der jeweiligen Version ab als vom Herkunftsland des Anbieters. Mehrere europäische Anbieter haben Leistungsunterschiede inzwischen verkleinert, indem sie EU-basierte Infrastruktur mit lizenzierten oder Open-Source-Modellen kombinieren, statt ein vollständig eigenes Modell von Grund auf zu trainieren. Ein solcher hybrider Ansatz kann Anforderungen an die Datenresidenz erfüllen, ohne die Modellleistung zwangsläufig einzuschränken. Die tatsächliche Qualität sollte dennoch immer für den konkreten Anwendungsfall getestet werden.
Eine realistische Bewertung sucht keinen pauschalen Gewinner. Organisationen ohne besonderen regulatorischen Druck und ohne Vorgaben zur Datenresidenz haben oft wenig praktischen Nutzen von einem Wechsel, wenn das aktuelle Tool die bestehenden DPA-Bedingungen bereits erfüllt. Für Organisationen mit branchenspezifischen Beschaffungsregeln oder vertraglich festgelegten Vorgaben zur Datenresidenz kann eine Verarbeitung innerhalb Europas dagegen faktisch erforderlich sein – unabhängig davon, ob die Funktionen eines anderen Tools gleichwertig sind. Diese Anforderung sollte sich jedoch immer aus dem konkret geltenden Gesetz, einer Ausschreibung, einem Kundenvertrag oder einer internen Richtlinie ableiten lassen und nicht nur aus dem allgemeinen Ruf eines Anbieters. Teams, die parallel zu Content-Tools auch CRM-Systeme bewerten, stehen vor einem strukturell ähnlichen Entscheidungsprozess. Mehr dazu findest du in dieser Übersicht: Europäische CRM-Alternativen für datenschutzbewusste B2B-Teams.
Checkliste vor dem Wechsel eines KI-Schreibtools
Ein Tool-Wechsel sollte als Beschaffungsentscheidung mit klar definierten Prüfschritten behandelt werden – nicht als Einführung nach dem Prinzip Versuch und Irrtum. Die folgende Reihenfolge umfasst Prüfungen, mit denen sich typische Compliance-Lücken bereits vor der Vertragsunterzeichnung erkennen lassen. Wie lange die einzelnen Schritte dauern, hängt vor allem von den internen Freigabeprozessen und davon ab, wie schnell der Anbieter reagiert – nicht von einem pauschalen Branchendurchschnitt.
- Vollständige Liste der Unterauftragsverarbeiter anfordern und sich schriftlich bestätigen lassen, wo die Daten tatsächlich verarbeitet werden – statt sich lediglich auf die Aussage zu verlassen, der Anbieter "unterstütze" EU-Kunden.
- Standardmäßige Nutzung von Kundendaten für das Modelltraining klären: ausdrücklich klären, ob eingegebene Texte standardmäßig zum Training oder Fine-Tuning von Modellen verwendet werden und ob ein Opt-out vertraglich garantiert ist – statt lediglich über eine jederzeit änderbare Einstellung angeboten zu werden.
- Zugrunde liegendes Foundation Model und die vollständige Verarbeitungskette des gebuchten Tarifs ermitteln. Ein in den USA entwickeltes Modell kann je nach Bereitstellung vollständig innerhalb der EU beziehungsweise des EWR betrieben werden. In anderen Fällen leitet derselbe Anbieter Prompts möglicherweise an eine in den USA gehostete API weiter. Die Offenlegung im DPA macht diese Übermittlung transparent, ändert aber nicht den tatsächlichen Verarbeitungsort. Deshalb Plattformvertrag und DPA direkt prüfen: Eine öffentliche, an Verbraucher gerichtete Datenschutzerklärung des zugrunde liegenden Modellanbieters gilt nicht zwangsläufig für Enterprise- oder API-Verträge.
- Aufbewahrungsfristen und Löschverfahren prüfen für Entwürfe, Prompts und generierte Inhalte – einschließlich der Frage, wie lange Daten nach einer Löschanfrage noch in Backups gespeichert bleiben.
- Integrationsaufwand abschätzen für bestehende Content-Workflows, einschließlich CMS-Plugins, Styleguide-Import und API-Authentifizierung. Wie viel Zeit ein vollständiger redaktioneller Rollout benötigt, hängt von der Teamgröße und den vorhandenen Prozessen ab. Eine realistische Schätzung lässt sich daher besser aus bisherigen Onboarding-Projekten der eigenen Organisation ableiten als aus pauschalen Branchenwerten.
- Aktuelle Sicherheitsnachweise direkt beim Anbieter anfordern, etwa ein ISO/IEC-27001-Zertifikat oder einen SOC-2-Type-II-Bericht. Dabei handelt es sich um unterschiedliche Nachweisarten – eine Zertifizierung einerseits und einen Prüfbericht andererseits. Deshalb auch Geltungsbereich, abgedeckte Dienste, Prüfungszeitraum und dokumentierte Ausnahmen prüfen, statt sich nur auf ein Siegel auf der Marketingseite zu verlassen.
Wer einen dieser sechs Schritte auslässt, verlagert Risiken aus der Anbieterprüfung in den späteren Betrieb. Dort lassen sich Lücken meist schwerer und mit deutlich höherem Aufwand beheben.
Häufig gestellte Fragen zu europäischen KI-Schreibtools
Sind europäische KI-Schreibtools genauso leistungsfähig wie ChatGPT oder Jasper?
Wie leistungsfähig ein Tool ist, hängt vor allem vom zugrunde liegenden Modell ab – nicht vom Unternehmenssitz des Anbieters. Anbieter mit einem eigenen oder lizenzierten, in der EU entwickelten Modell können bei bestimmten Benchmarks hinter den größten US-amerikanischen Foundation Models liegen. Anbieter, die unter europäischen Vertragsbedingungen hybride oder lizenzierte Nicht-EU-Modelle einsetzen, können bei der Ausgabequalität dagegen sehr nah herankommen. Leistungsfähigkeit und geografische Herkunft sollten deshalb getrennt bewertet werden, idealerweise anhand direkter Tests mit repräsentativen Aufgaben.
Gewährleistet ein europäisches Tool automatisch die Einhaltung der DSGVO?
Nein. Ein Firmensitz in Europa allein garantiert keine DSGVO-Konformität. Entscheidend sind die konkreten Verarbeitungsvorgänge, die Rechtsgrundlage, das Data Processing Agreement (DPA), der tatsächliche Serverstandort sowie die Frage, ob Unterauftragsverarbeiter außerhalb der EU bzw. des EWR beteiligt sind und welche Schutzmaßnahmen dafür gelten. Diese Punkte müssen anhand des Vertrags und der zugrunde liegenden Dokumentation geprüft werden – sie lassen sich nicht allein aus dem Standort des Anbieters ableiten.
Kann ein europäisches KI-Schreibtool trotzdem ein in den USA entwickeltes Sprachmodell nutzen?
Ja, das ist durchaus üblich. Ob eine solche Konfiguration strenge Vorgaben zur Datenresidenz innerhalb der EU bzw. des EWR erfüllt, hängt davon ab, wie das Modell tatsächlich bereitgestellt wird. Läuft es vollständig innerhalb der EU bzw. des EWR, kann die geforderte Datenresidenz eingehalten werden. Werden Prompts dagegen an eine in den USA gehostete API übertragen, ist eine strikte EU-only-Vorgabe in der Regel nicht erfüllt – auch dann nicht, wenn diese Übermittlung im DPA transparent ausgewiesen wird. Entscheidend ist deshalb die vollständige Verarbeitungskette im Verhältnis zu den konkret geltenden Anforderungen an die Datenresidenz.
Wie lange dauert der Wechsel eines KI-Schreibtools für ein mittelgroßes Content-Team realistisch?
Das hängt stark von der Sensibilität der verarbeiteten Daten, den internen Freigabeprozessen, den erforderlichen Integrationen und der Qualität der Anbieterdokumentation ab. Ein gut dokumentierter Wechsel mit geringem Risiko kann von der ersten Bewertung bis zum Rollout innerhalb weniger Wochen abgeschlossen sein. Sind Vertragsverhandlungen nötig oder ist die Kette der Unterauftragsverarbeiter komplex und unübersichtlich, kann die Prüfung deutlich länger dauern. Für eine realistische Planung sollten Teams daher eher auf ihre bisherigen Erfahrungen mit dem Onboarding neuer Anbieter zurückgreifen als auf pauschale Branchenwerte.
Die richtige Entscheidung basiert auf Kriterien, nicht auf Labels
Der Unternehmenssitz allein sagt wenig über die tatsächliche Compliance aus. Bei einer seriösen Bewertung sind der Ort der Datenverarbeitung und die Herkunft des zugrunde liegenden Sprachmodells mindestens ebenso wichtig. Ein als "europäisch" beworbenes Tool kann Prompts dennoch über ein Foundation Model außerhalb der EU verarbeiten. Umgekehrt kann ein Anbieter mit Muttergesellschaft außerhalb der EU Kundendaten aus der EU auf Grundlage eines dokumentierten DPA ausschließlich in Rechenzentren innerhalb der EU bzw. des EWR verarbeiten. Hinzu kommt, dass es keine allgemein anerkannte Definition dafür gibt, was "europäisch" in diesem Zusammenhang genau bedeutet. Deshalb sollte immer klar sein, ob sich die Bezeichnung auf den Unternehmenssitz, die Datenresidenz oder die Herkunft des Modells bezieht.
Für ein Content-Team, das einen Wechsel erwägt, ist der nächste Schritt klar: Von jedem Anbieter auf der Shortlist die Liste der Unterauftragsverarbeiter anfordern, die vollständige Verarbeitungskette des eingesetzten Modells klären und vor Vertragsabschluss schriftlich bestätigen lassen, ob Kundendaten für das Modelltraining verwendet werden. Aussagen wie „DSGVO-konform“ sind dabei lediglich ein Ausgangspunkt für die eigene Prüfung – kein Beleg an sich.